IA + maty + fco = <3 …
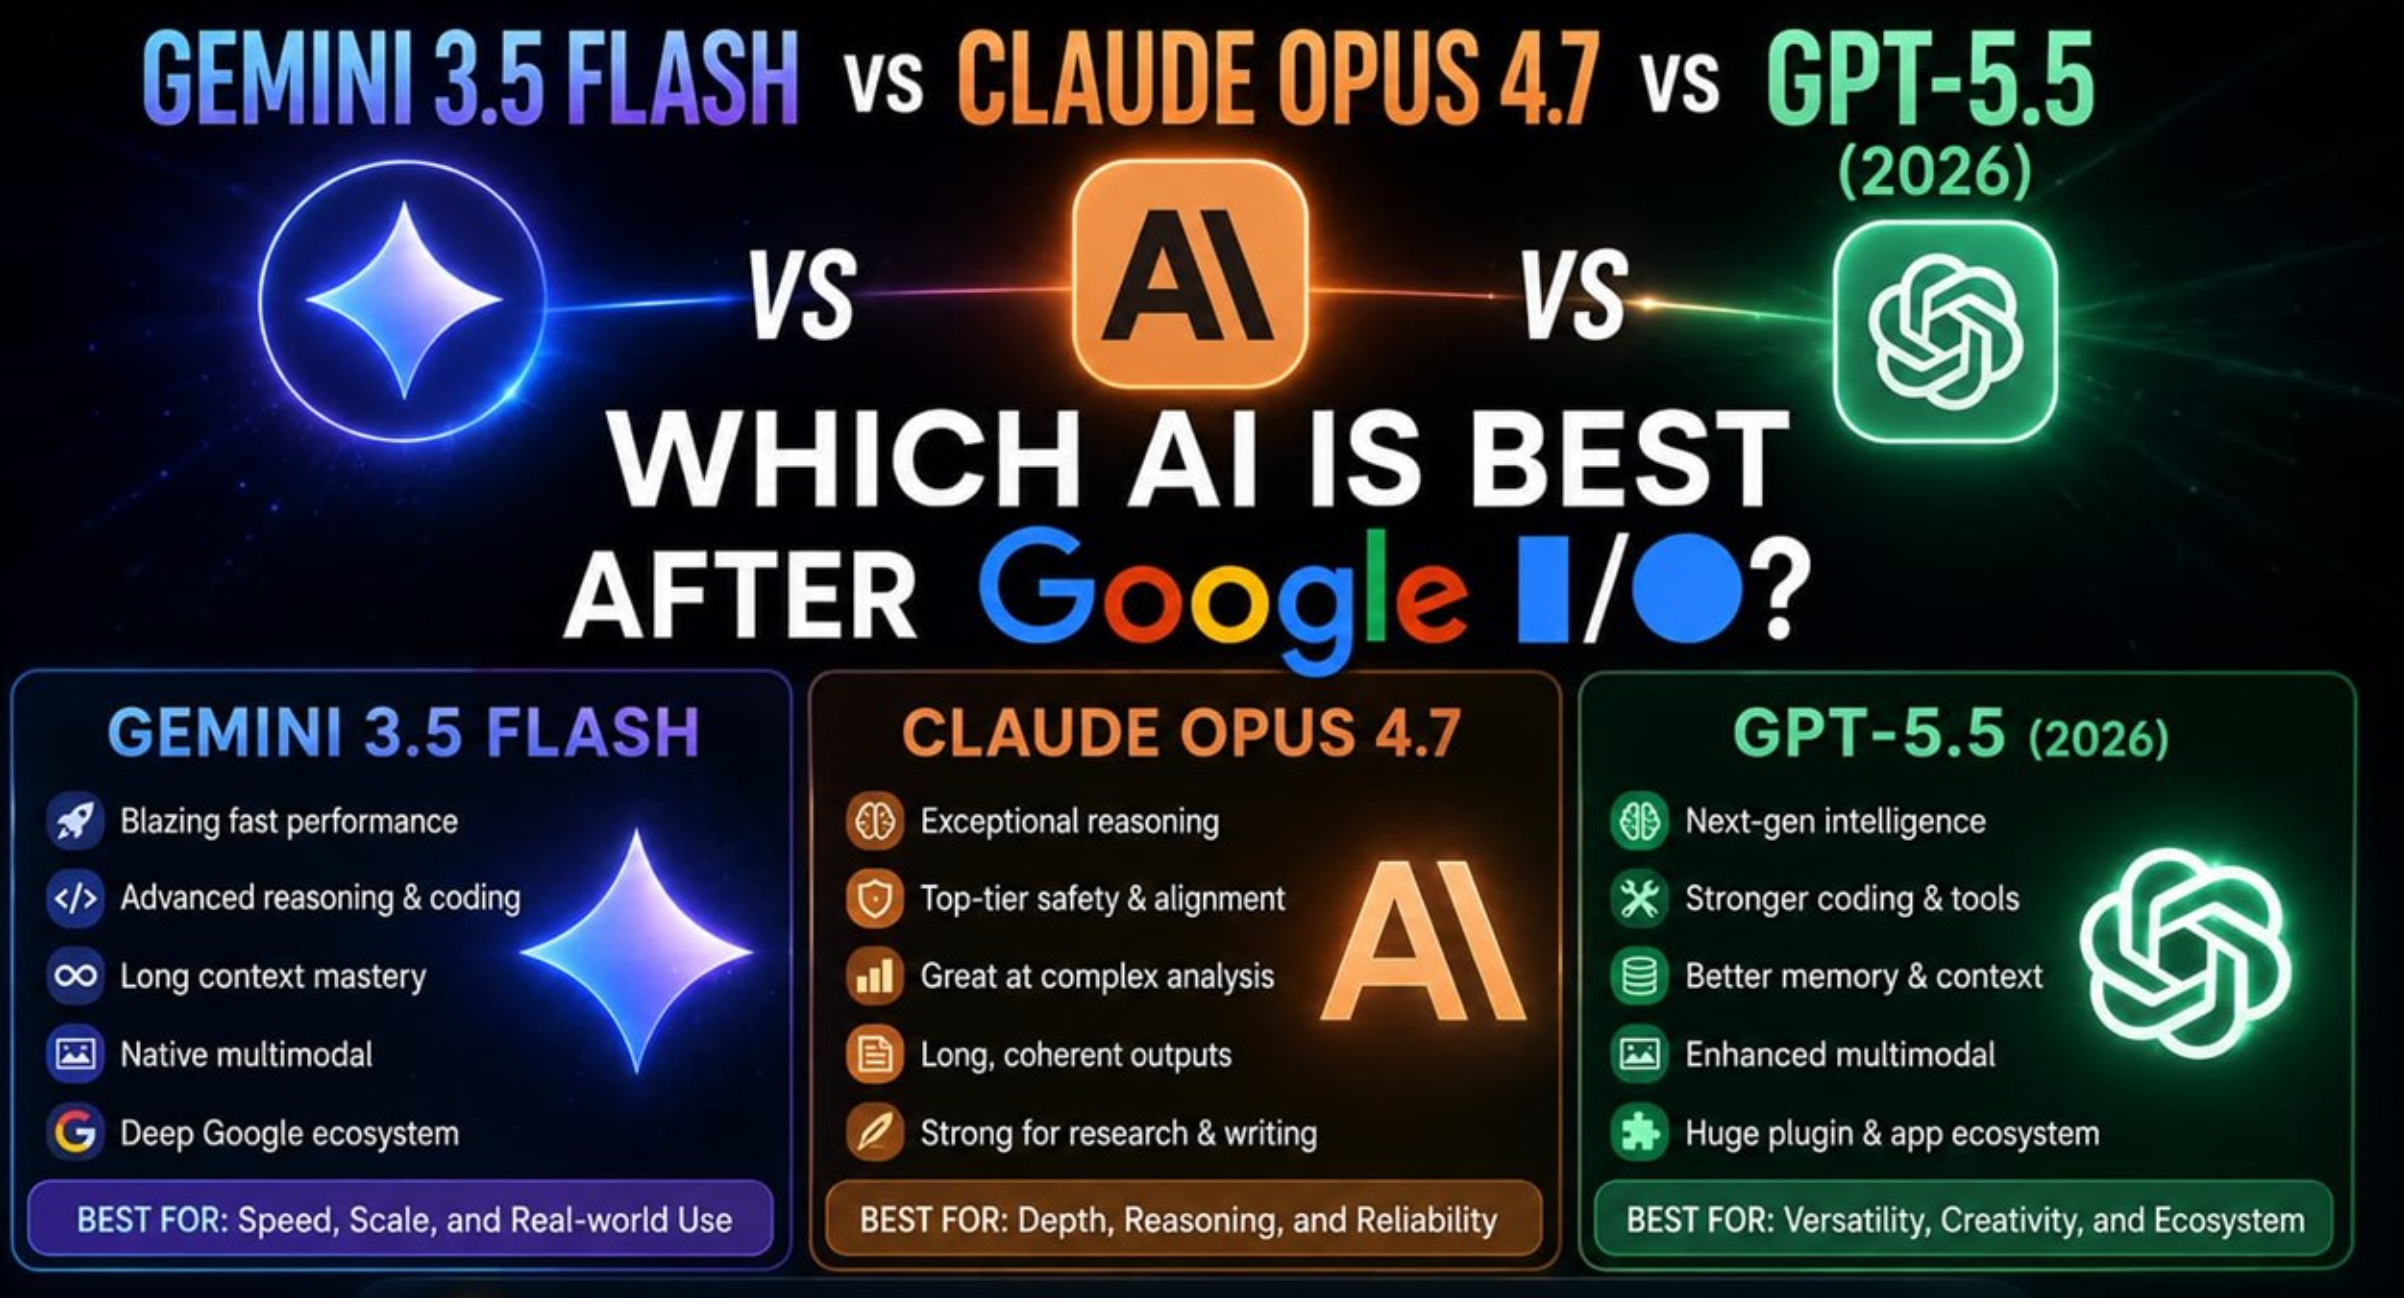
La realidad …
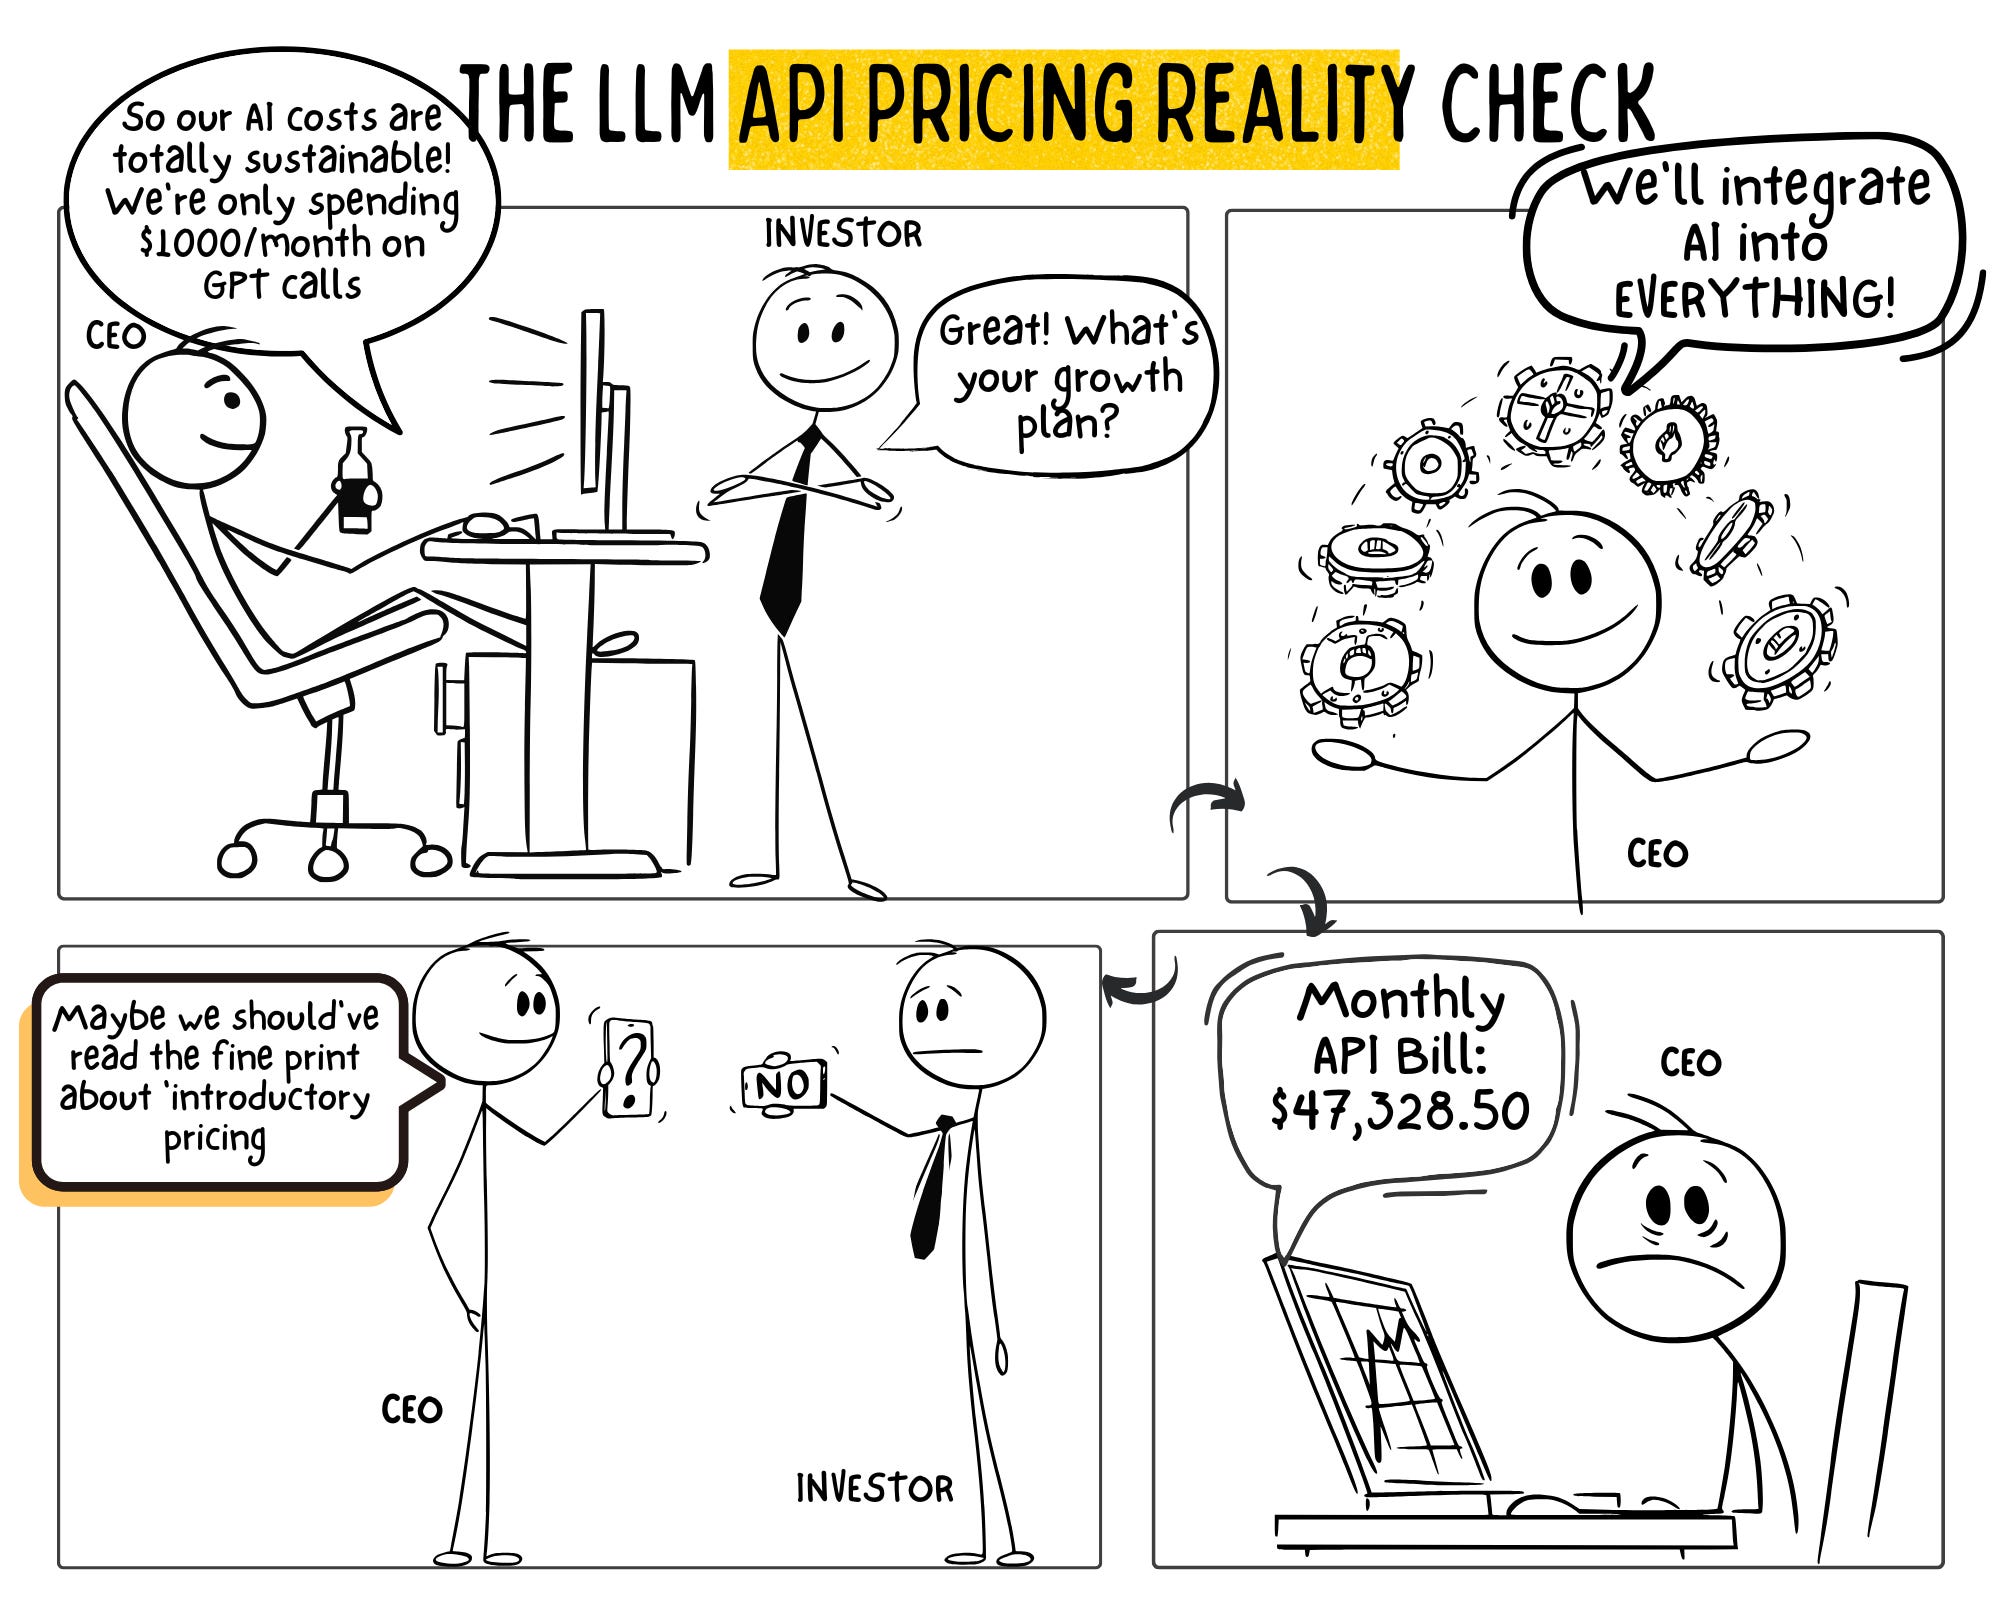


La triste realidad …


Parte 1

¿Qué son los LLMs?

Spoiler: no razonan, predicen

Large Language Models


  • Un LLM es una red neuronal entrenada con cantidades masivas de texto.
  • Aprende distribuciones de probabilidad sobre secuencias de tokens.
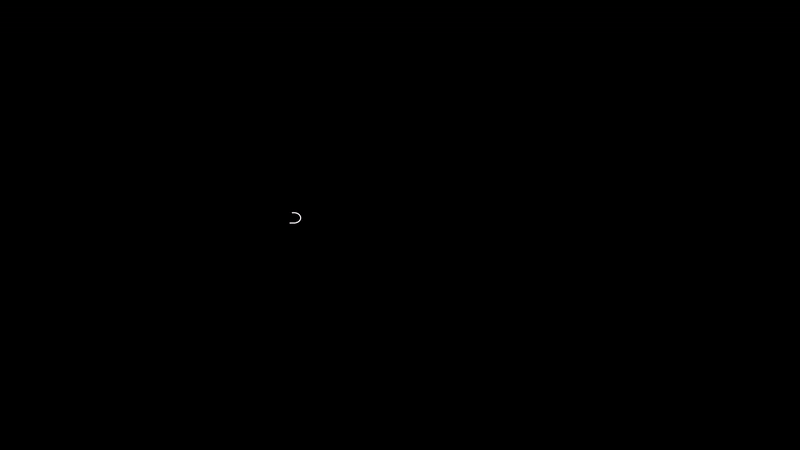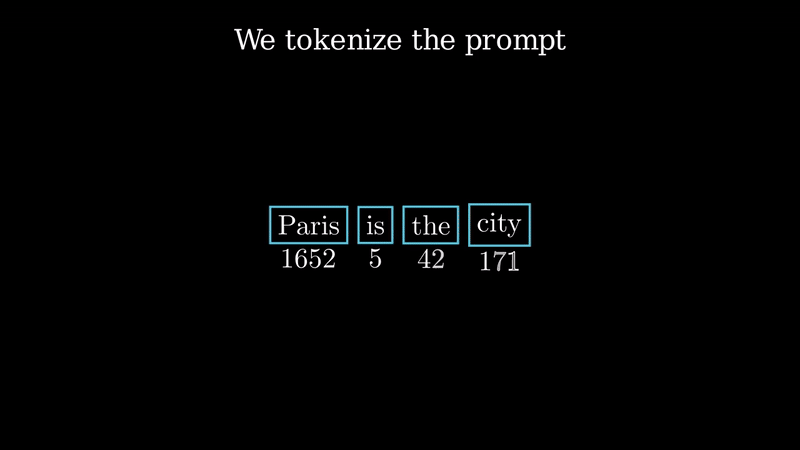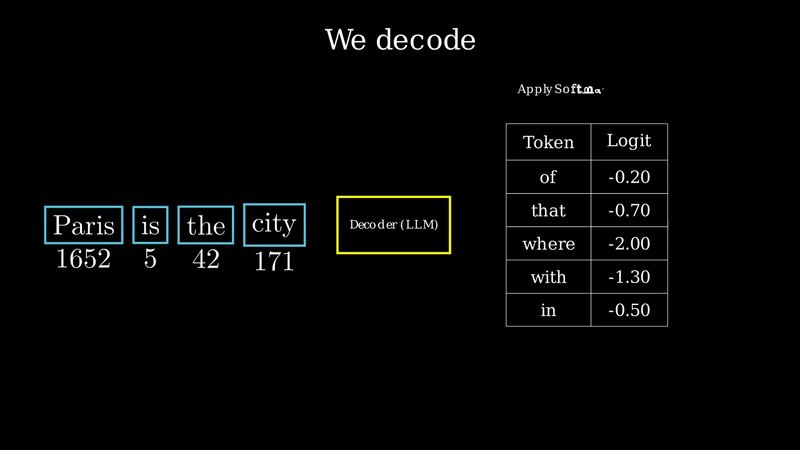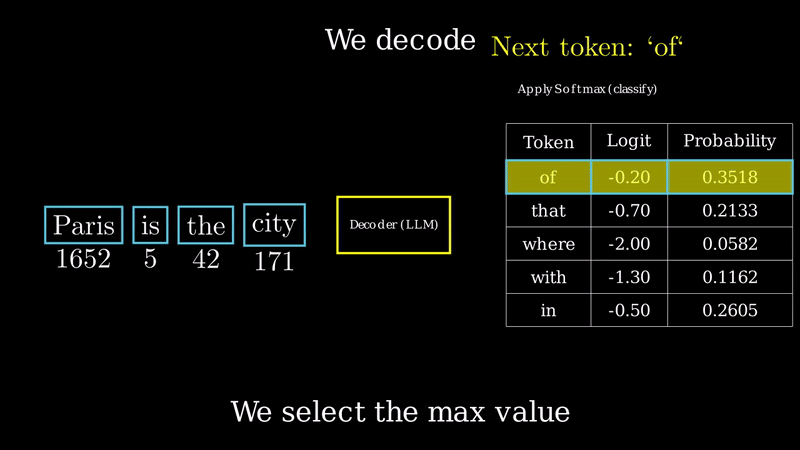
  • Su tarea fundamental: predecir el siguiente token más probable.
  • No tiene un modelo del mundo. No tiene intenciones. No “entiende”.
  • Todo lo que parece razonamiento es interpolación estadística muy sofisticada.


🧠 ¿Qué hace un LLM?
Input: "El cielo es de color"
↓ tokeniza
[231, 4892, 12, 8743, ...]
↓ atiende + predice
P("azul") = 0.71 · P("gris") = 0.12 · ...
No hay comprensión. Solo probabilidad.


La frase más importante de esta charla

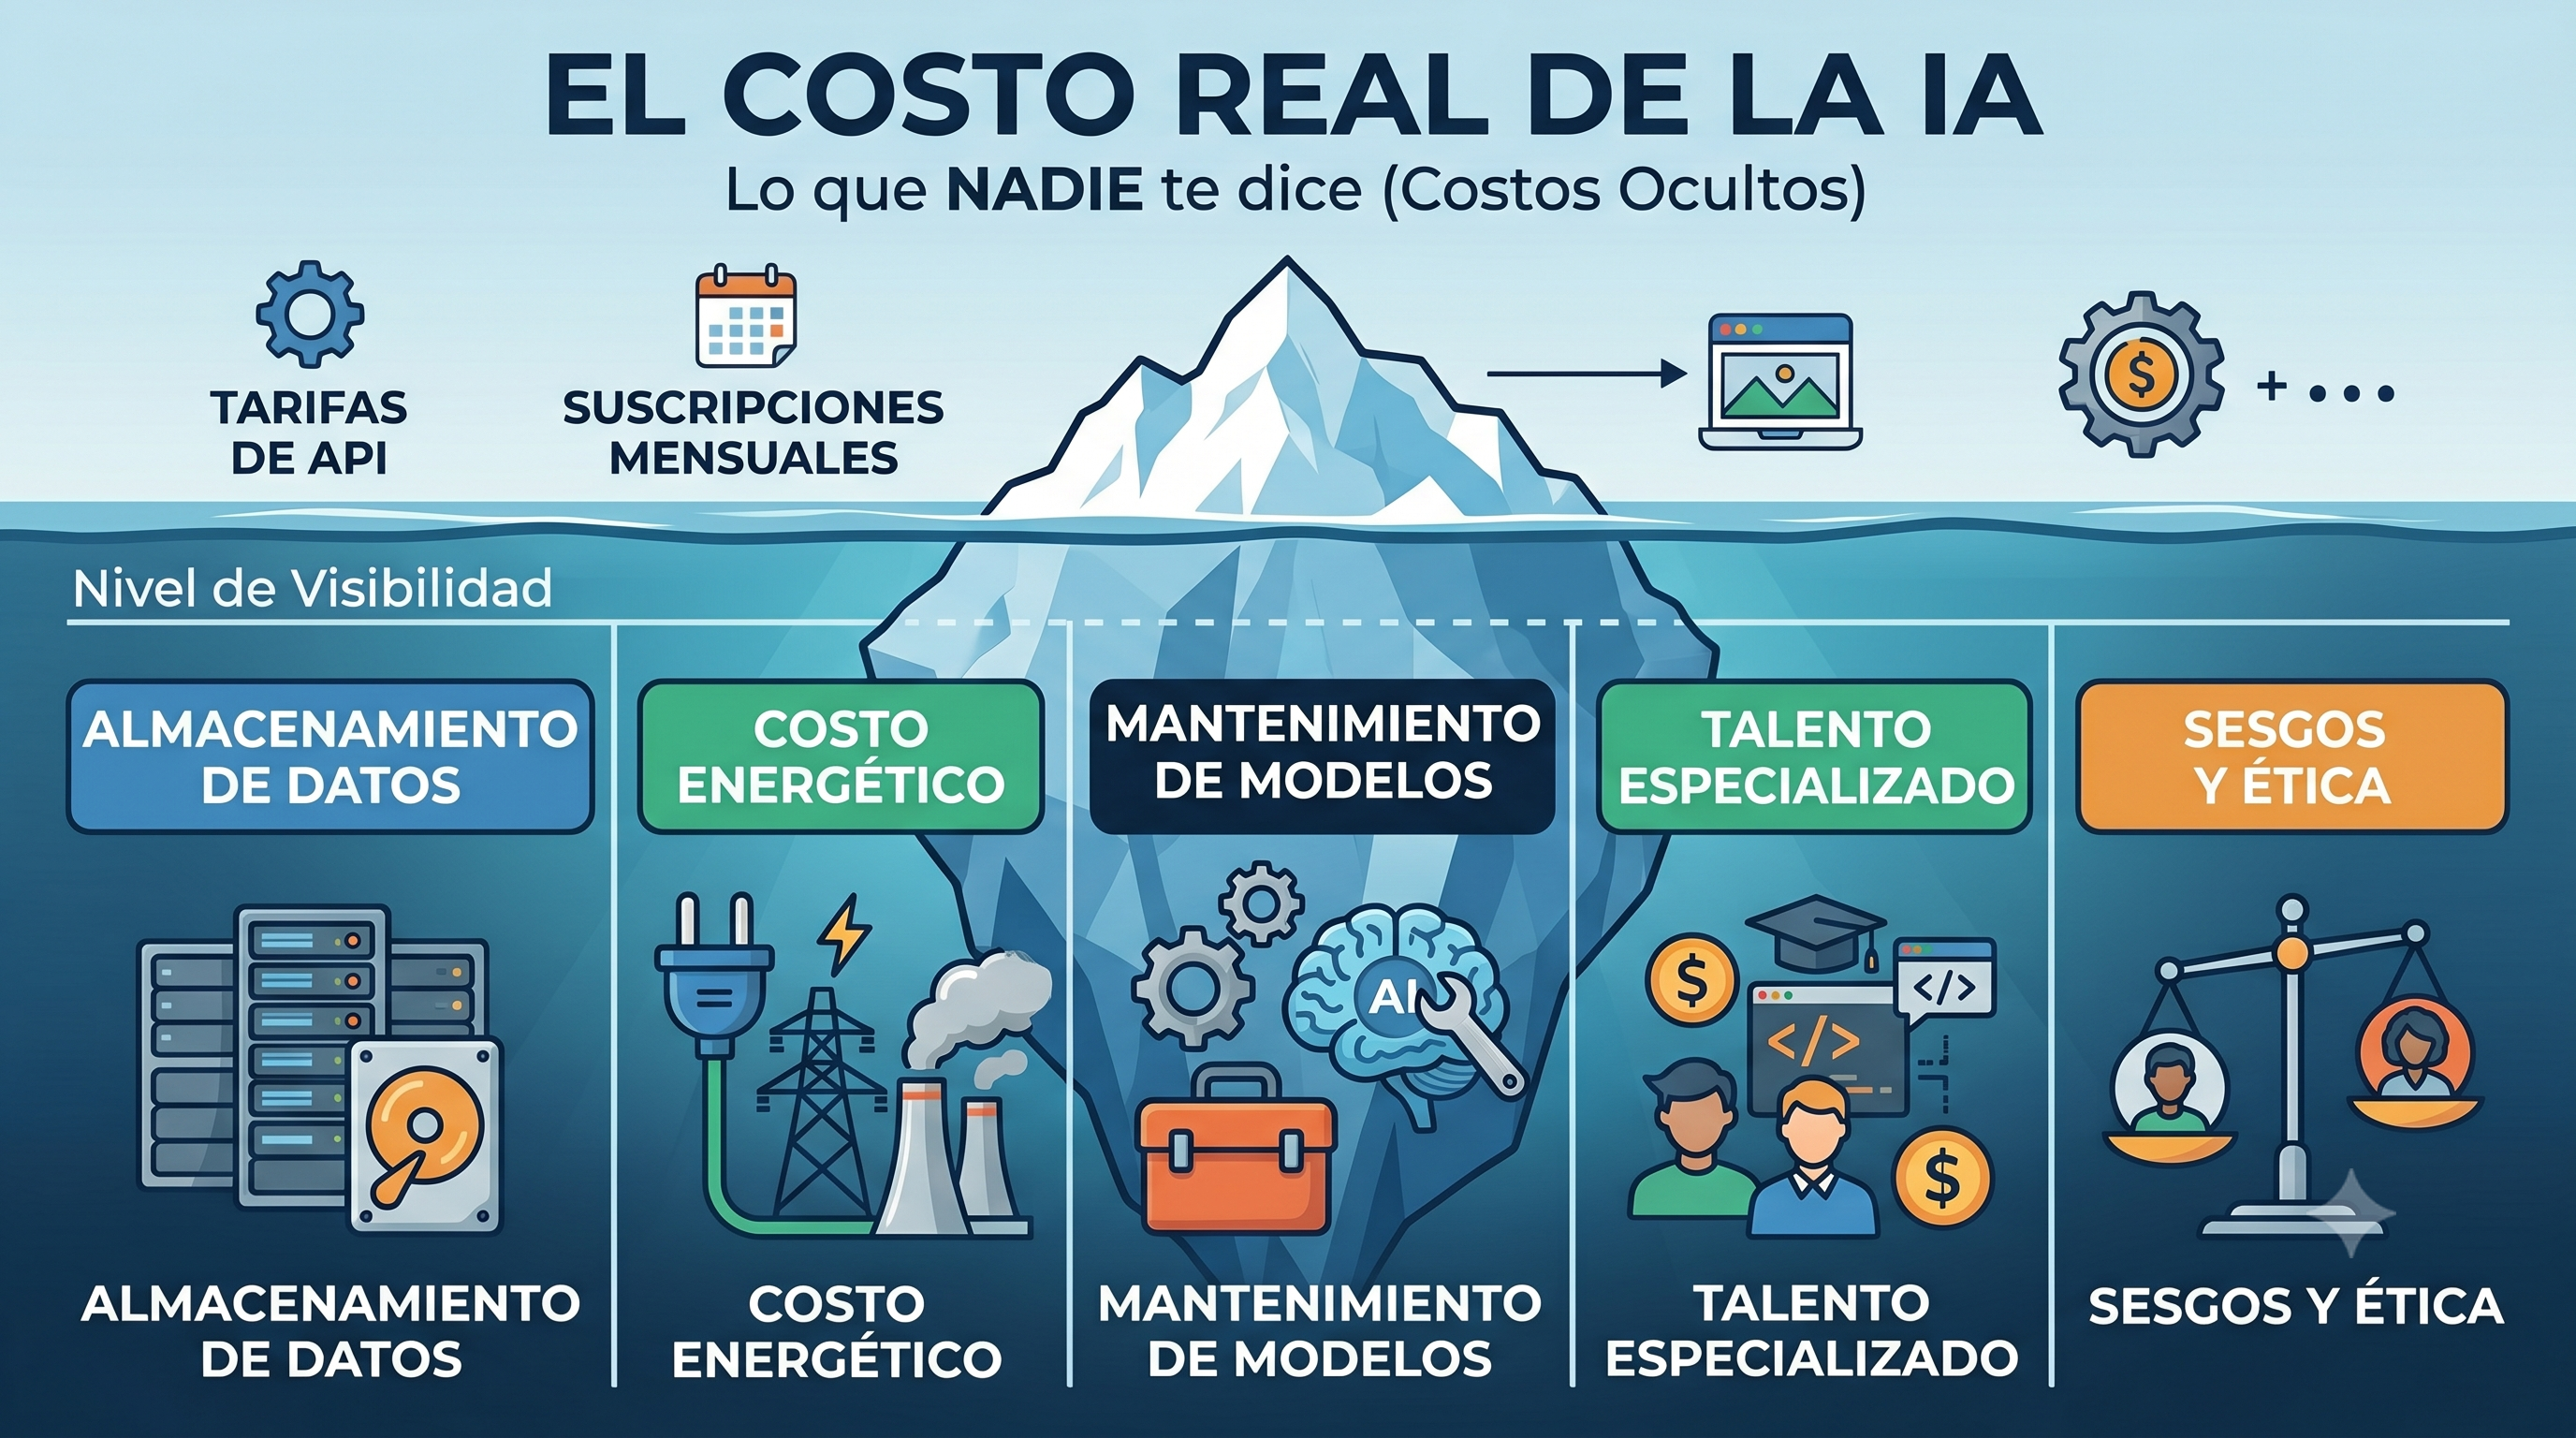
Un LLM no razona, predice. Todo lo demás se deriva de entender esto bien. Incluido su costo.

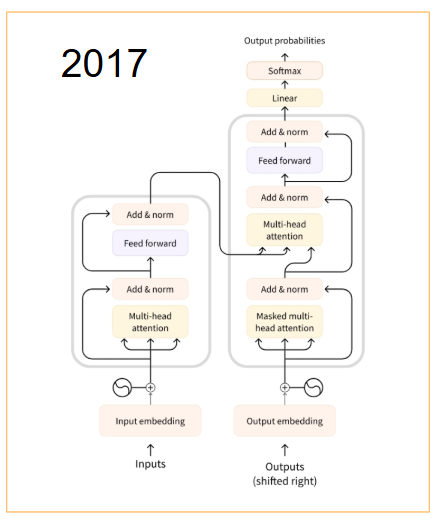
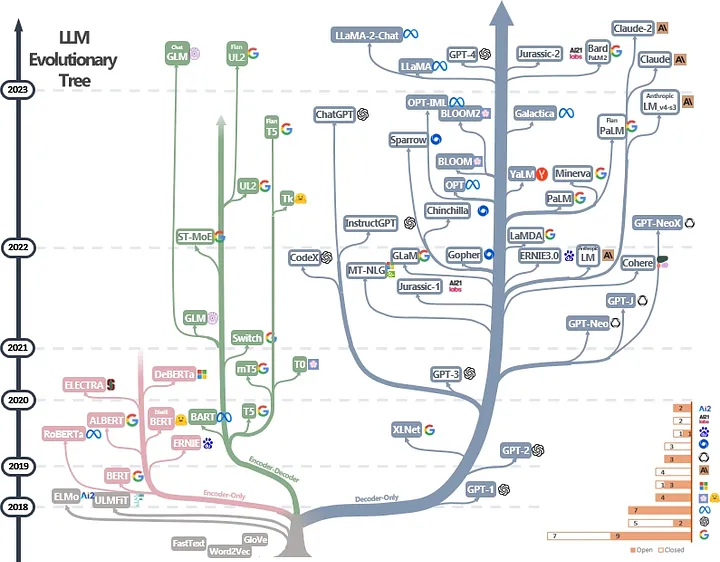
Historia de los LLM


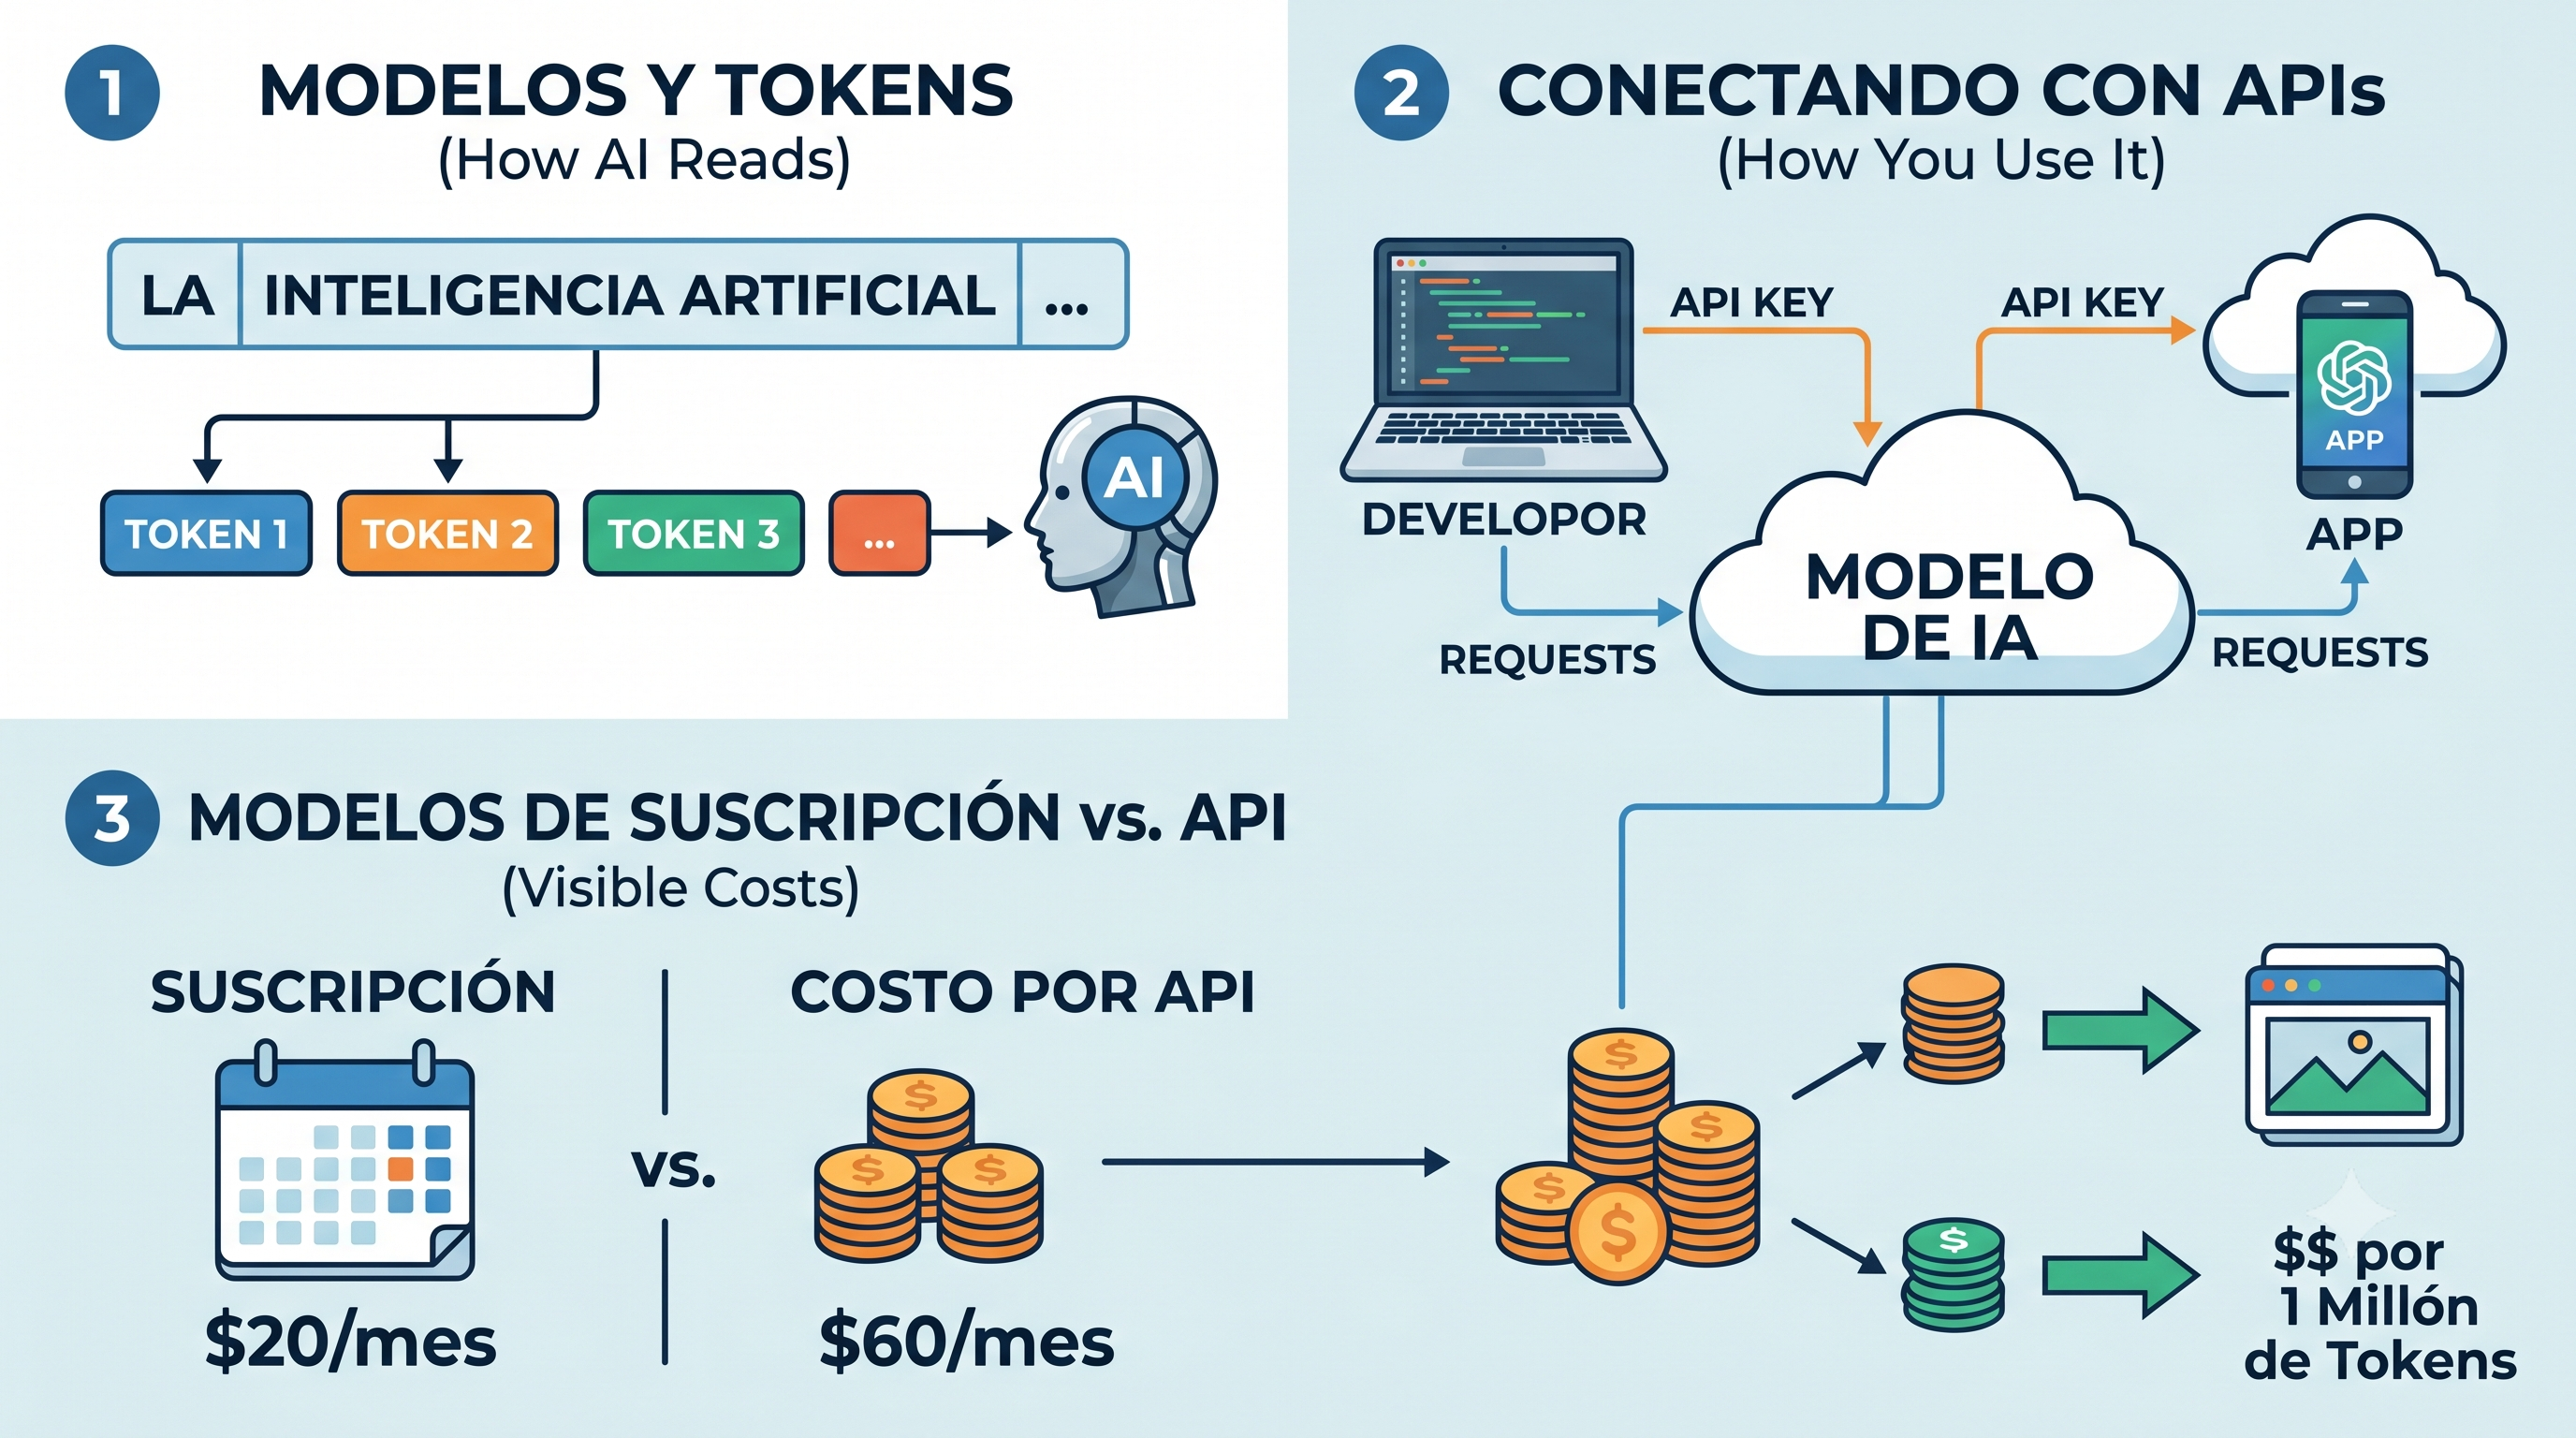
De texto a tokens — la unidad económica de la IA


  • Los modelos no procesan palabras, procesan tokens (fragmentos de texto).
  • Un token ≈ 0.75 palabras en inglés. En español: menos eficiente (~0.6).
  • La tokenización afecta directamente el costo, la velocidad y la precisión.
  • Palabras técnicas, nombres propios o en otro idioma usan varios tokens.
  • Cada token que envías y recibes se cobra. Sin excepciones.


📏 ¿Cuántos tokens usa tu contenido?
📄 1 página A4 ≈ 500 tokens
📚 1 libro estándar ≈ 100K tokens
💻 100 líneas de código ≈ 800 tokens
🖼️ 1 imagen (vision) ≈ 765–2K tokens
📊 CSV 1000 filas × 10 cols ≈ 15–50K tokens
⚠️ Enviar un dataset completo a la API puede costar $0.05–$2 por llamada.

Tokenizador interactivo

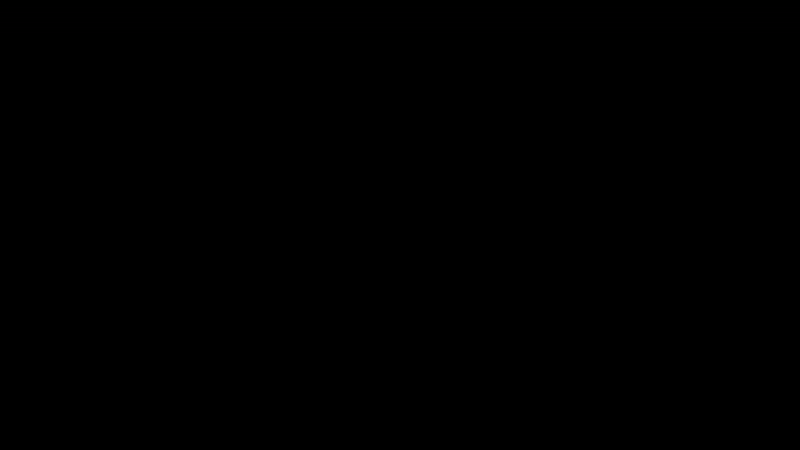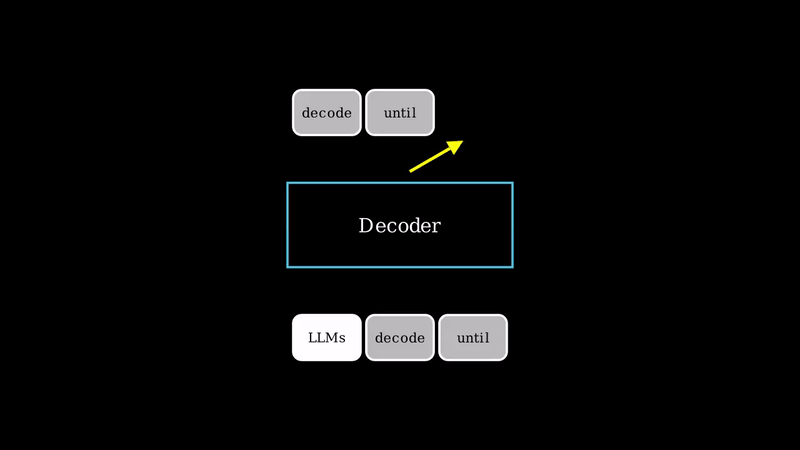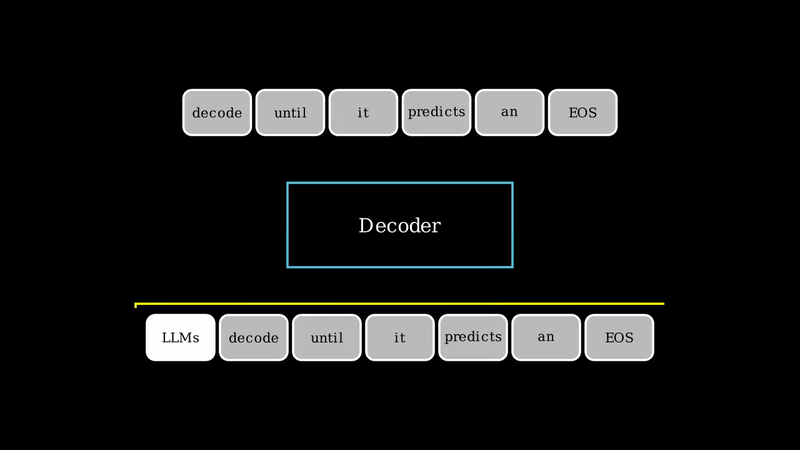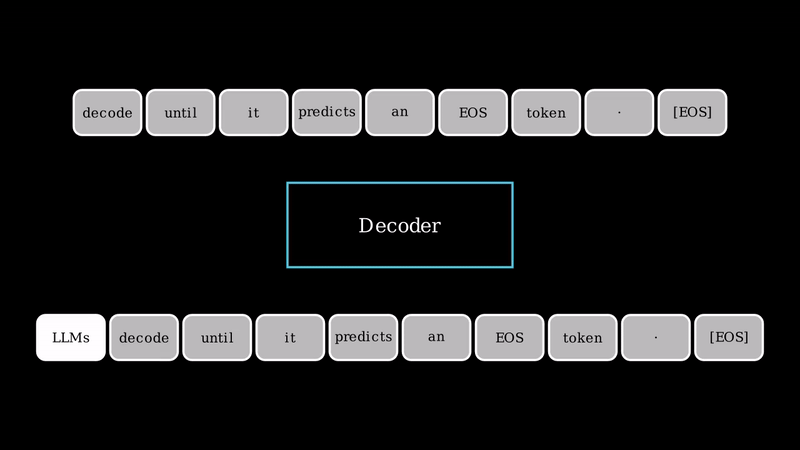
Diagrama de un LLM — animado


Parte 2

Prompt Engineering aplicado a datos

No son trucos, son formas de comunicarse con precisión

¿Qué es un Prompt?


Un prompt es la interfaz entre tú y el modelo. Cada palabra cuenta — literalmente.

Componentes de un prompt efectivo:

  • 🎯 Instrucción: qué quieres que haga
  • 🎭 Rol: quién debe ser el modelo
  • 📄 Contexto: info relevante (solo la necesaria)
  • 🖼️ Formato: cómo responder (JSON, número, tabla)
  • 📌 Ejemplos: qué es correcto / qué no
[ROL] Eres un econometrista experto en salarios.
[CONTEXTO] Dataset wage1, n=526, EE.UU.
[INSTRUCCIÓN] Interpreta el coeficiente de educ.
[FORMATO] Responde en JSON con keys:
 {"interpretacion": "...", "es_causal": false}

Parte 3

RAG: conectar la IA a tus datos

La solución al problema del contexto y el costo

RAG: Retrieval-Augmented Generation


El problema que resuelve:

El modelo no conoce tu información privada ni actualizada. Meter todo el dataset en el contexto es caro e ineficiente. RAG inyecta solo el contexto relevante.

Flujo básico:

  1. 📄 Ingest: indexas tus documentos en una base vectorial
  2. 🔍 Retrieve: recuperas los fragmentos más relevantes
  3. 💬 Augment: inyectas esos fragmentos en el prompt
  4. 🤖 Generate: el modelo responde usando tu información

La analogía del buscador

RAG es como Google para tus datos privados: no te entrega toda la web, te entrega los 10 resultados más relevantes para tu query.

Parte 5

Agentes de IA

Tendencias que ya están en marcha

¿Qué es un Agente de AI?


Un agente percibe su entorno, planifica y actúa de forma autónoma — repitiendo el ciclo sin intervención humana.

Componentes de un agente:

  • 🌍 Entorno: el mundo con el que interactúa — SO, API, navegador
  • 🧠 Planificación: el LLM razona antes de actuar (ReAct, CoT, ToT)
  • 🗄 Memoria: contexto inmediato (corta) + base persistente (larga)
  • 🔧 Herramientas: funciones externas — búsqueda, código, BD, APIs
  • ↺ Loop autónomo: actúa → observa → replantea, sin humano en cada paso

Claude Code on VSCode

Parte 6

Demo en vivo

Aplicar todo los aprendido

De cero a RAG

📓 Google Colab + OpenAI API

Construye aplicaciones con LLMs desde cero hasta RAG

Colab · API keys seguras · Prompt Engineering · RAG de punta a punta

Abrir en Google Colab

Recursos para seguir aprendiendo

Libros

Build a LLM from Scratch — Raschka
Designing ML Systems — Huyen
AI Engineering — Huyen (2025)

Papers fundamentales

Attention is All You Need Vaswani 2017
Few-Shot Learners Brown 2020
Constitutional AI Bai 2022
Extracting Training Data Carlini 2021

Costos · comunidad

PyCon Chile · PyDay Valparaíso · LatinR · useR!

Hora del Adiós